
像[/S2/]稳定扩散这样的生成式AI模型在文本到图像的合成中越来越受欢迎。CLIP或BLIP等文本图像评分方法可以评估模型生成的图像是否与文本提示匹配,但并不总是符合人类的偏好和感知。
清华大学和北京邮电大学团队开发了首个通用的文本到图像人类偏好奖励模型——ImageReward,主要解决了改进生成模型中的各种常见问题(如稳定差),接受人类反馈的训练,使之与人类的价值观和偏好相一致。
ImageReward使用强化学习和人类反馈进行训练,这是一种受OpenAI的CLIP启发的方法。ImageReward已经由137,000张人工评分的AI图像进行了训练,有望提供更好的图像合成。在各种基准测试中,ImageReward比CLIP、审美或BLIP等其他评分方法高出30%至近40%。
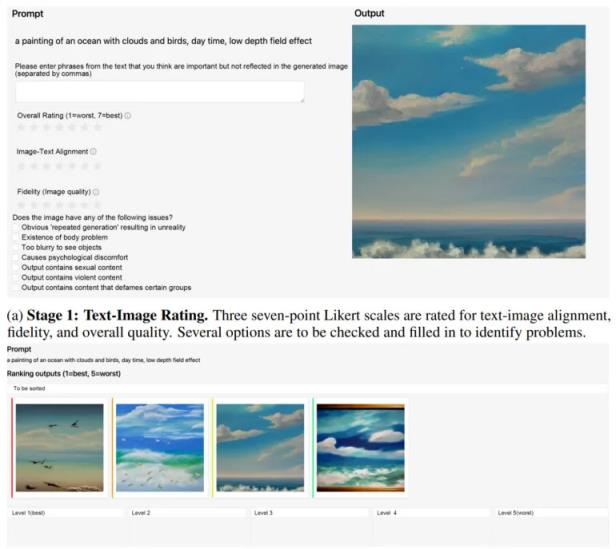
ImageReward从根据各种标准对AI图像进行排名的人类分数中学习。
在实践中,ImageReward实现了文本和图像之间更好的对齐,减少了身体的扭曲渲染,更好地匹配了人类的审美偏好,减少了毒性和偏见。在几个例子中,该团队展示了ImageReward如何影响图像质量。他们要求不同的文本图像评分者从第64代图像中选择最佳图像。
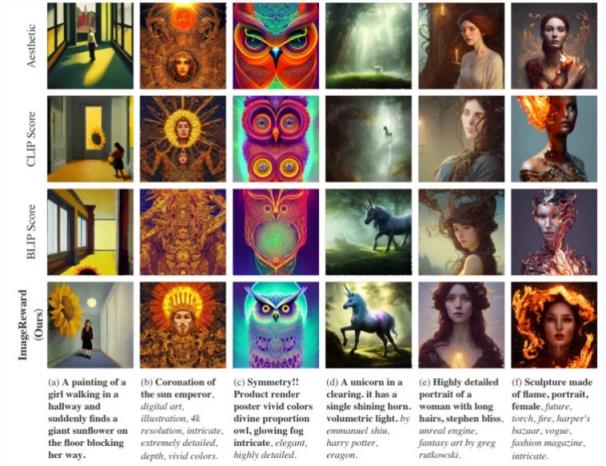
与CLIP等其他文本图像评分方法相比,ImageReward在大多数情况下都能产生更好的结果。
该团队希望在未来与研究社区合作,找到一种方法,将ImageReward作为RLHF中文本到图像模型的真正奖励模型。ImageReward可从GitHub获得,并提供了如何将其集成到稳定扩散WebUI中的说明。
ImageReward项目网站:
https://github.com/THUDM/ImageReward
郑重声明:本文内容及图片均整理自互联网,不代表本站立场,版权归原作者所有,如有侵权请联系管理员(admin#wlmqw.com)删除。
